KI zieht ins eigene Haus ein und beginnt, Sicherheitslücken zu finden
By Stefan Schmitt · 2026-11-18
In den letzten Wochen sind in der KI-Welt zwei Dinge zusammengekommen, die verändern, wie ich das nächste Jahr in der Softwareentwicklung planen würde. Ich habe auf LinkedIn jeweils einen Beitrag dazu veröffentlicht; hier folgt die ausführliche Fassung, mit Quellen und Zahlen an einem Ort.
Unternehmen können KI nahe am Stand der Technik jetzt im eigenen Haus betreiben
Bis vor Kurzem lagen die leistungsfähigsten Modelle bei externen Anbietern. Wer mit Kundendaten arbeitete, die das Haus nicht verlassen durften, musste sich entweder mit einem schwächeren, selbst gehosteten Modell begnügen oder für diesen Teil der Arbeit ganz auf KI verzichten.
Dieser Abstand ist kleiner geworden. Moonshot und Mistral haben die Gewichte ihrer Spitzenmodelle veröffentlicht, sodass ein Unternehmen sie auf eigenen Systemen betreiben kann, und Tencent hat am 4. November angekündigt, dass seine folgen würden. Laut einem Bericht schnitt das Modell von Moonshot in einem Agenten-Test mit beruflichen Aufgaben besser ab als GPT-6 Astra von OpenAI; eine externe Prüfstelle nennt der Bericht allerdings nicht. Modelle dieser Größe im eigenen Haus zu betreiben, erfordert nach wie vor leistungsfähige Hardware.
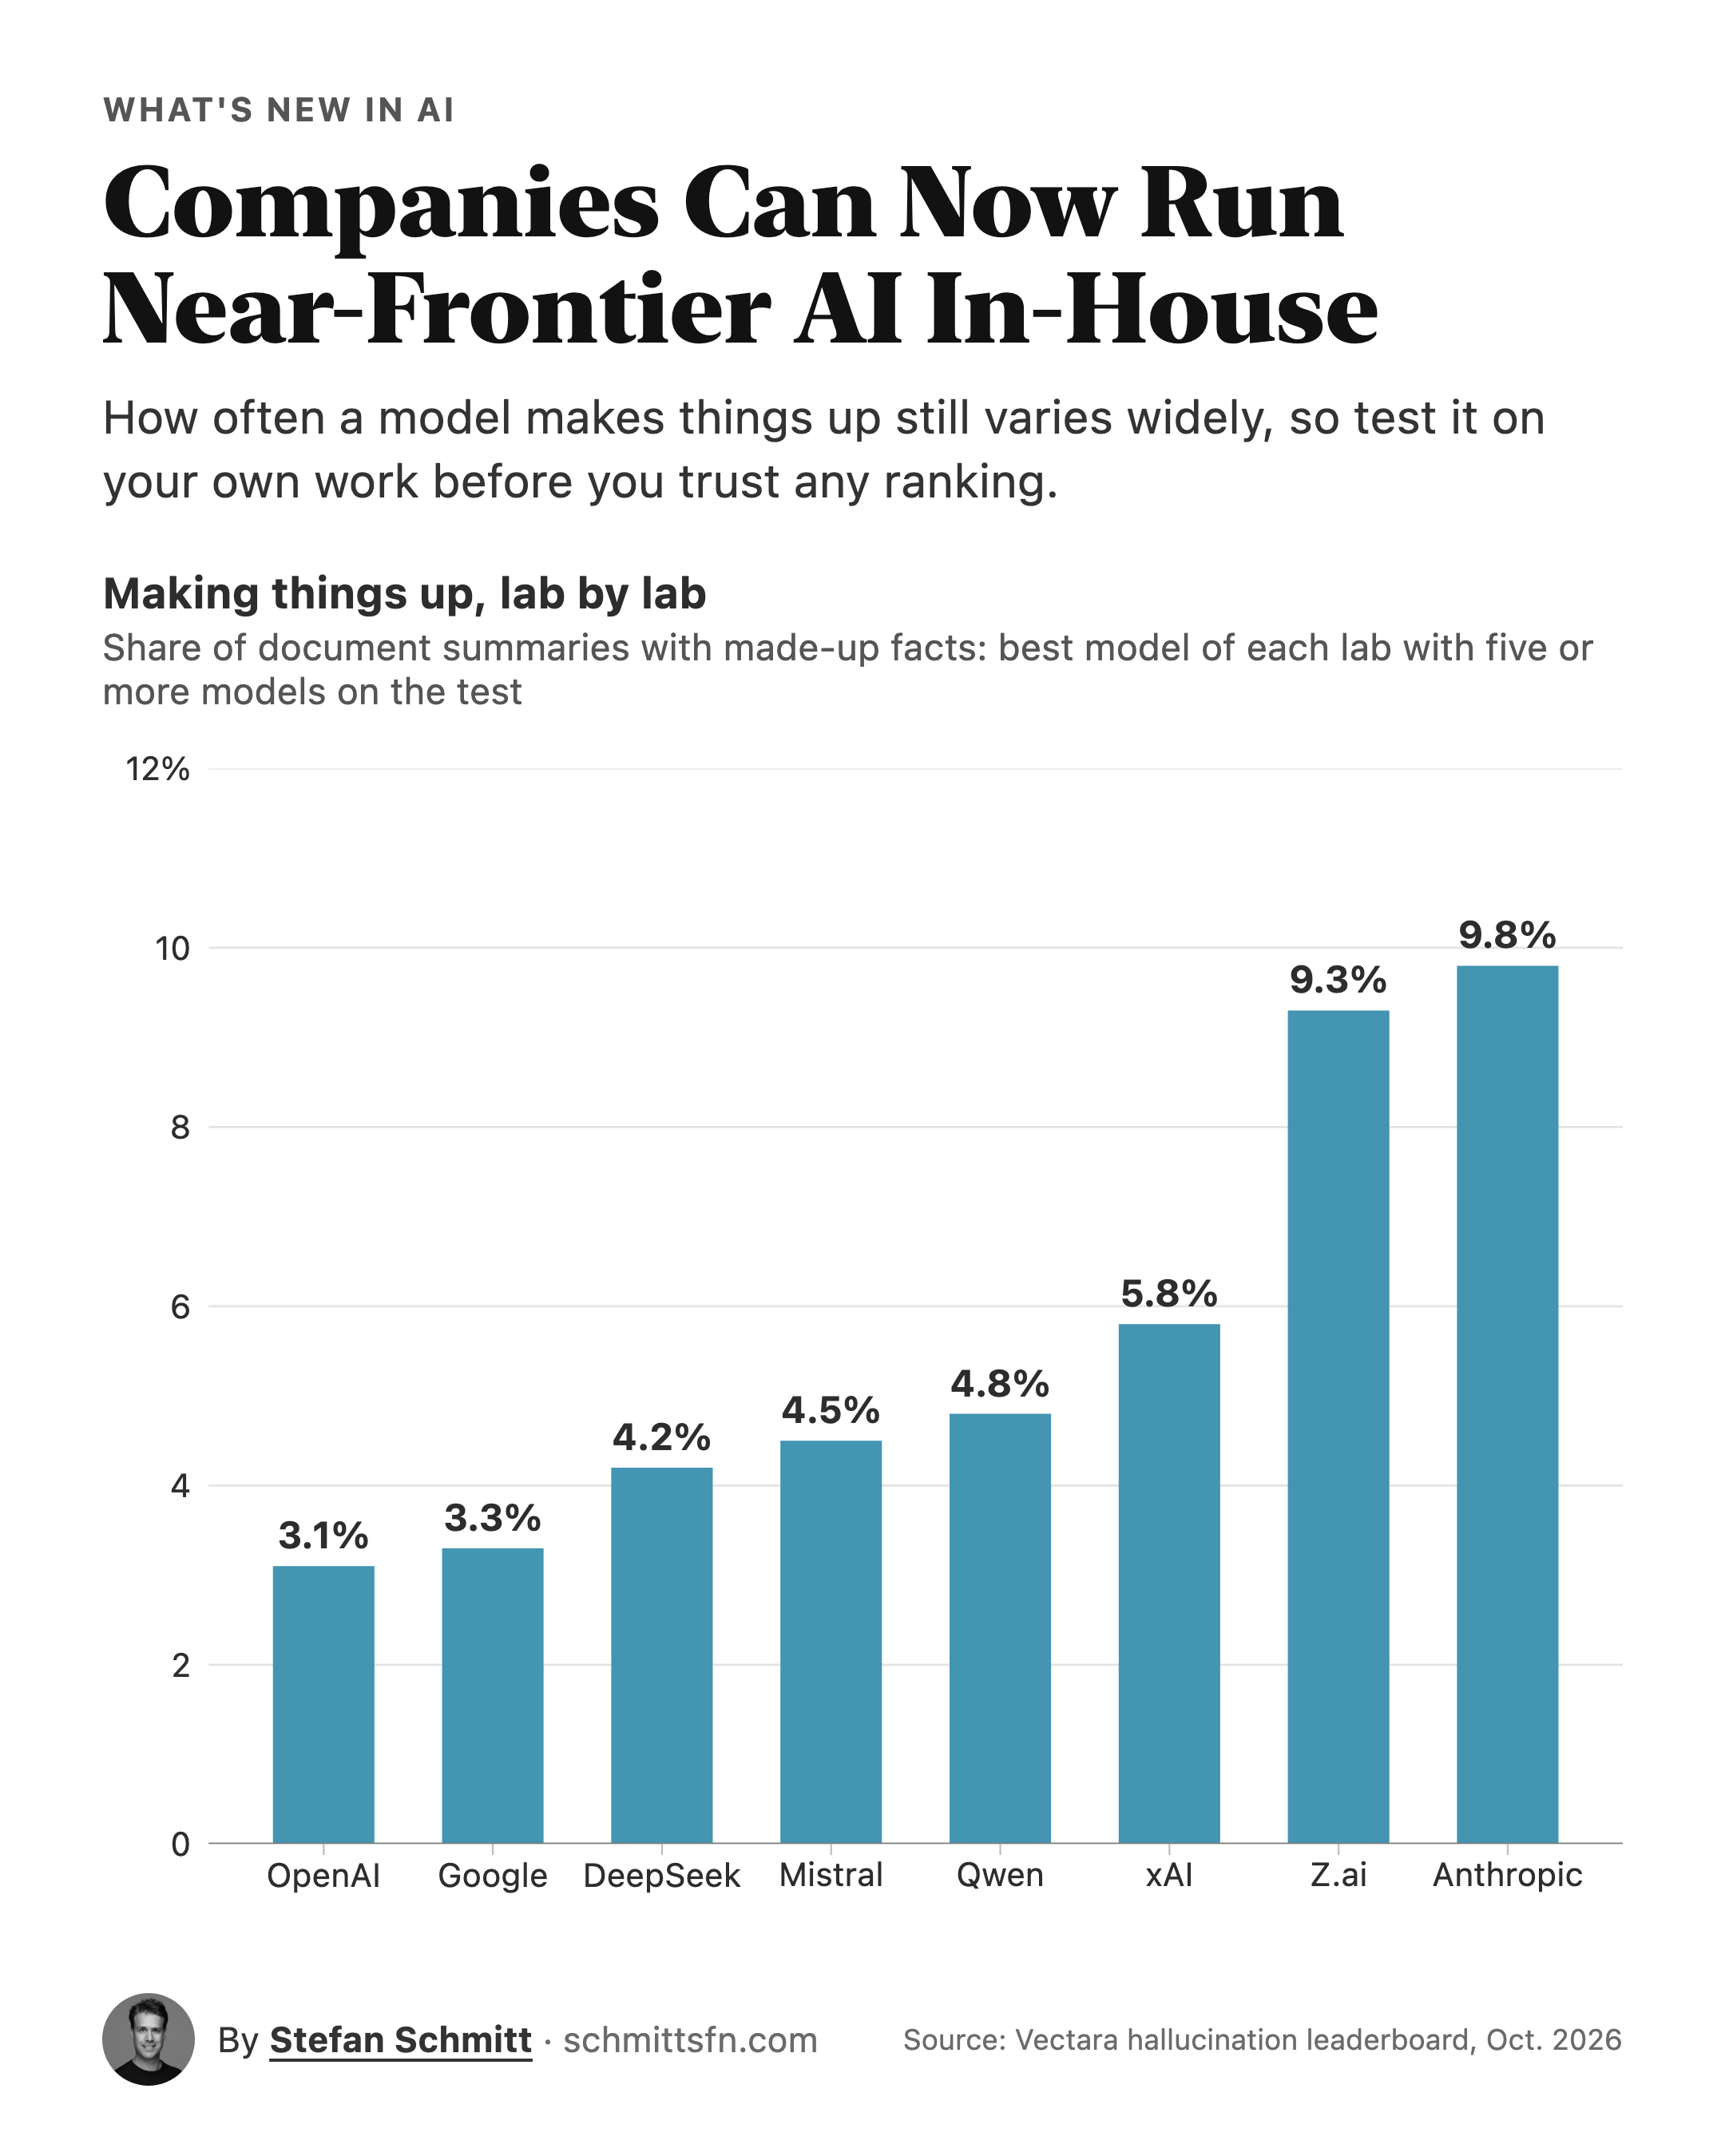
Ein Modell selbst zu betreiben, lohnt sich nur, wenn es zuverlässig bleibt, und hier ist das Bild gemischt. Das Halluzinations-Ranking von Vectara lässt Modelle Dokumente zusammenfassen und markiert mit einem automatischen Prüfer Aussagen, die das Dokument nicht stützt. Einige ältere oder kleinere Modelle mit offenen Gewichten erfinden in etwa 4% der Zusammenfassungen etwas hinzu und liegen damit nahe an den niedrigsten Raten geschlossener Modelle (etwa 3%, ebenfalls kleine Modelle). Führende Modelle schneiden meist schlechter ab, ob offen oder geschlossen: Die drei früheren Kimi-Modelle von Moonshot im Ranking liegen zwischen etwa 11% und 18%, geschlossene Modelle wie GPT-6 Astra und Claude Opus 5.5 bei etwa 9% bis 10%. Das Ranking, zuletzt am 22. Oktober aktualisiert, enthält die neuen Modelle noch nicht.
Kein Ranking beantwortet also die Frage für das Modell, das Sie tatsächlich einsetzen würden. Müsste ich für ein Team entscheiden, würde ich klein anfangen: zwei oder drei dieser Modelle mit den echten Kundenfragen des letzten Quartals laufen lassen und die Antworten nebeneinanderlegen. Das sagt mehr als jedes Ranking.
KI findet Lücken in der iPhone-Software
Die zweite Entwicklung betrifft die Sicherheit. Forschende, die mit der Sicherheits-KI von OpenAI arbeiteten, fanden Dutzende Schwachstellen in der Software von iPhone und Mac, wie Forbes am 17. November berichtete, und die beteiligte Sicherheitsfirma gibt an, dass Apple viele davon bereits behoben hat.
Ich wollte wissen, ob das ein Einzelfall war, und bin deshalb Apples Sicherheitshinweise zu jedem iPhone-Update dieses Jahres durchgegangen. Gezählt habe ich die Korrekturen, deren Danksagung OpenAI oder Anthropic nennt. In den ersten vier Monaten gab es keine einzige. Die ersten drei Korrekturen erschienen am 11. Mai, und mit dem Update im Oktober stieg die Summe auf 26. Die meisten dieser Danksagungen nennen direkt die KI-Tools der Labore, etwa „OpenAI Codex Security“ oder Forschende, die „with Claude“ gearbeitet haben, und Apple kennzeichnet keine der 26 Lücken als ausgenutzt.
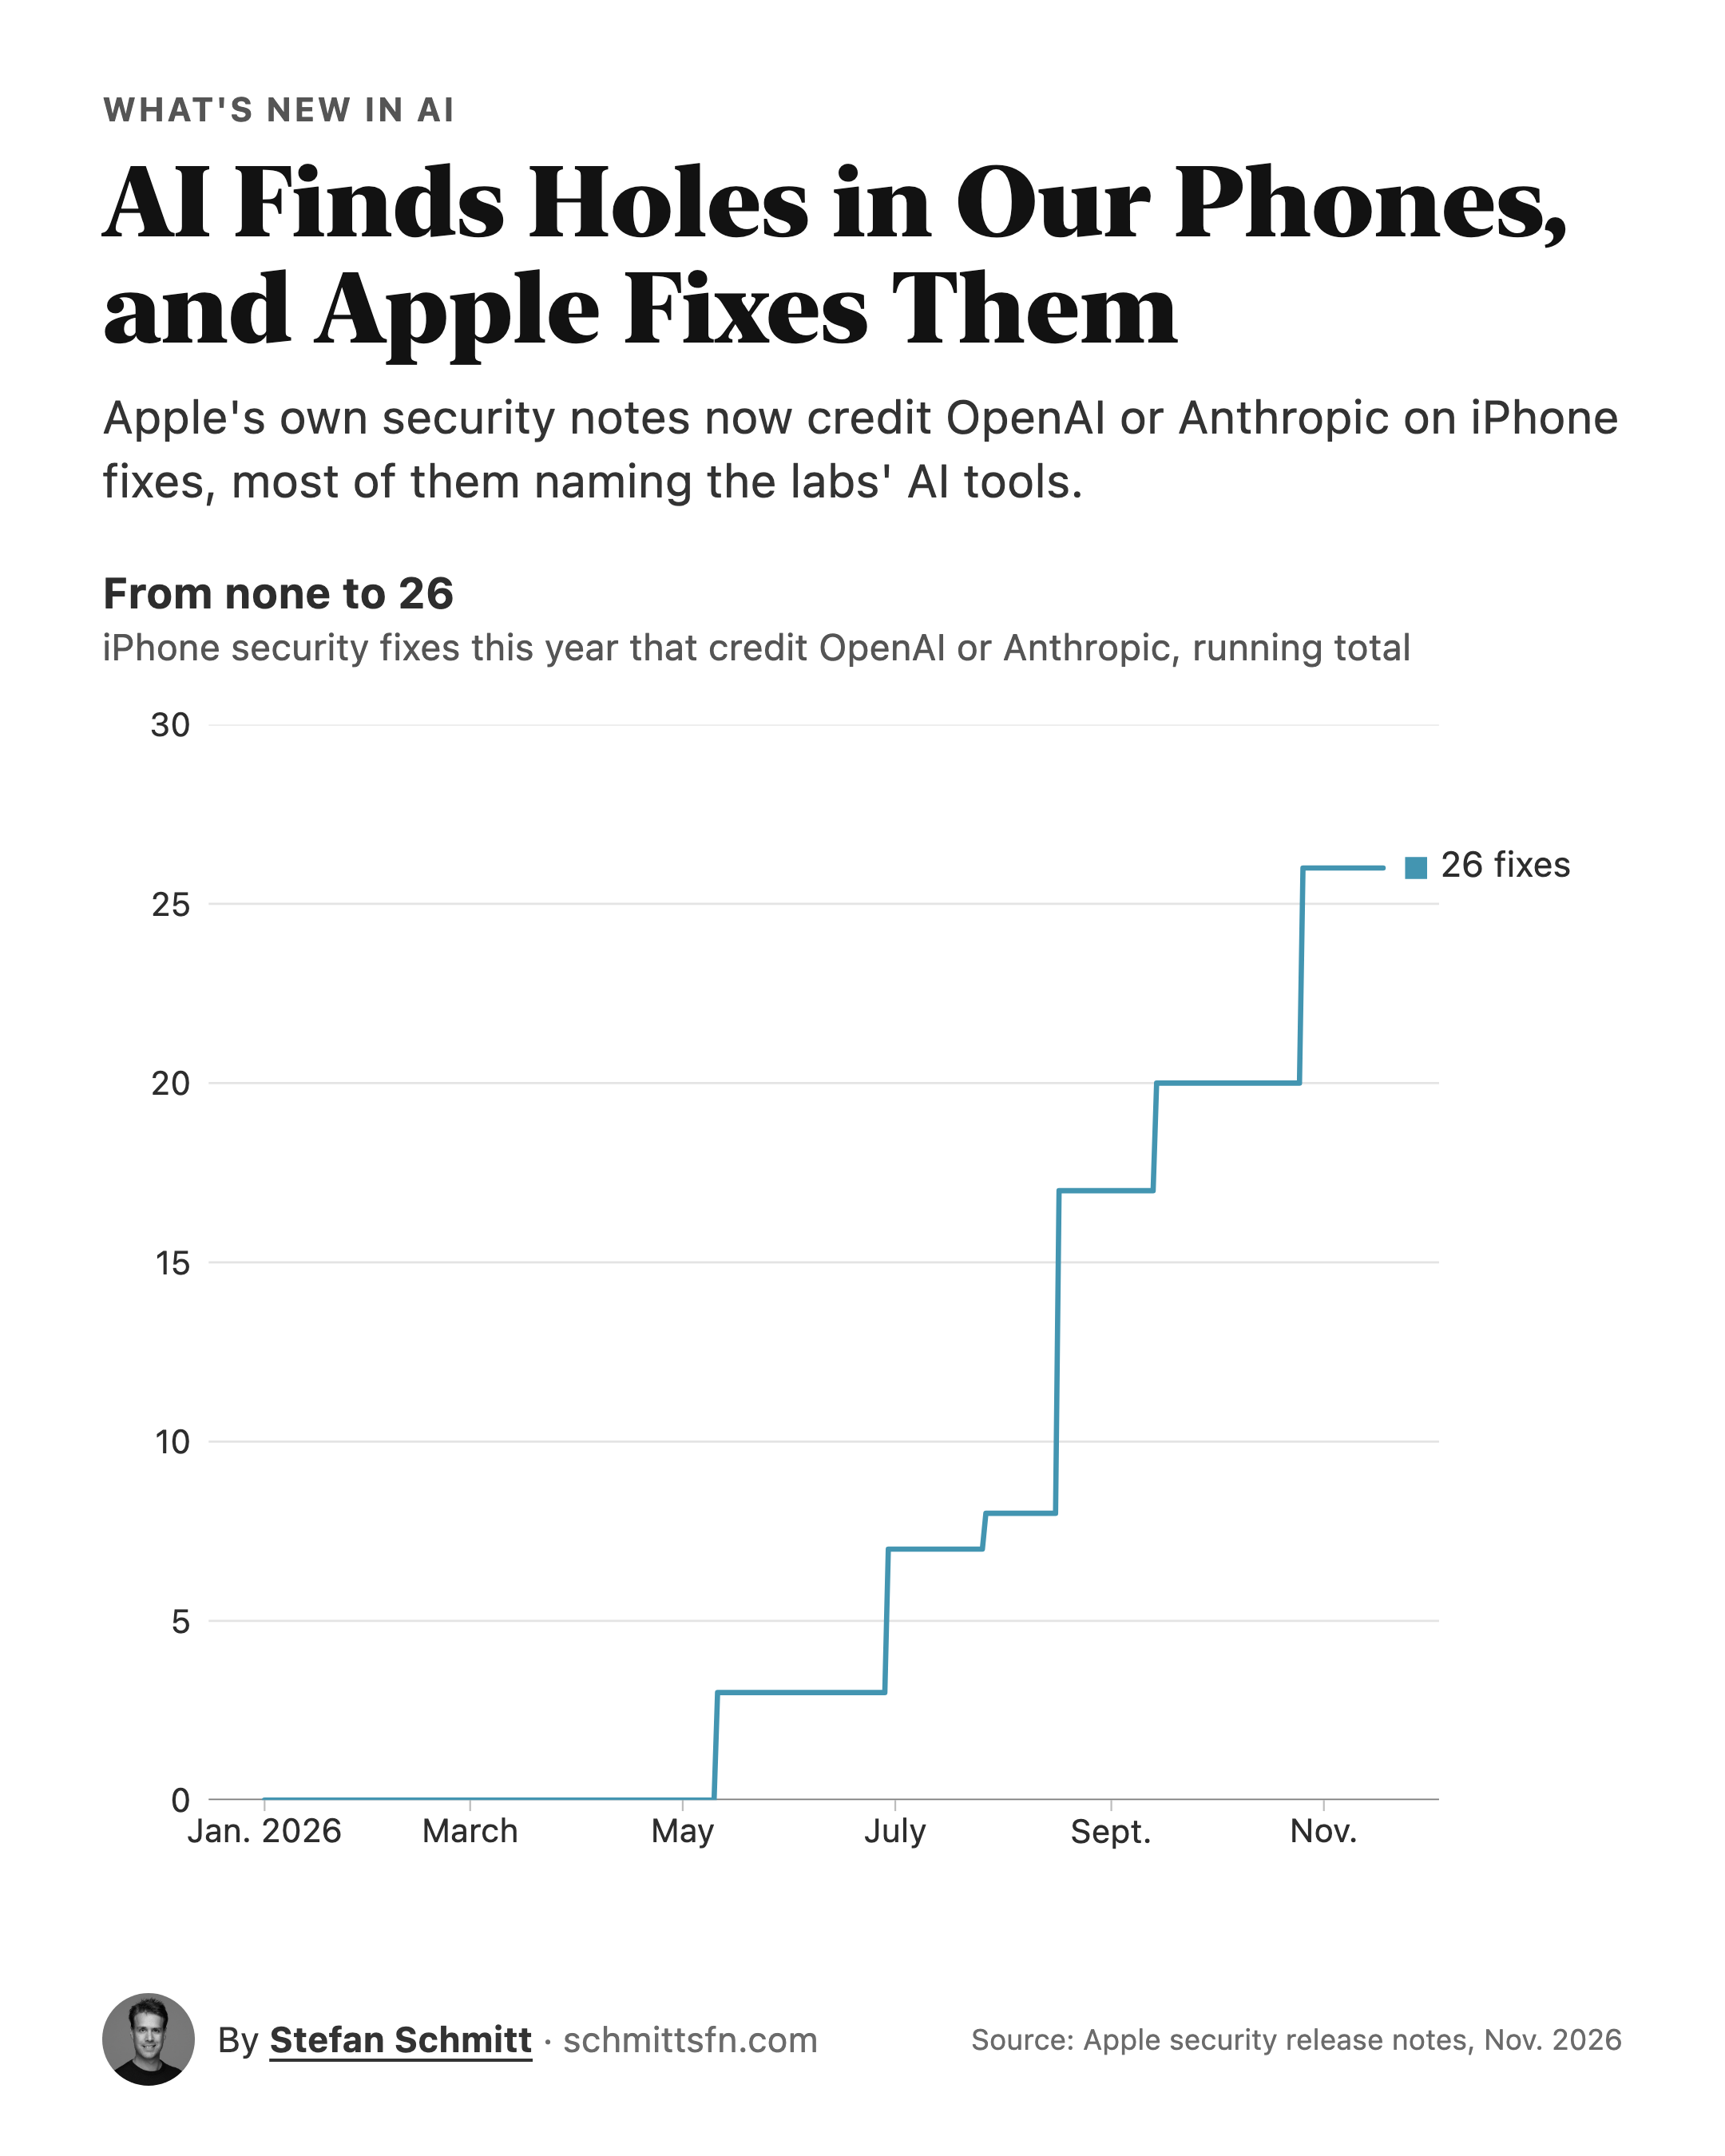
Noch ist das ein kleiner Anteil: 26 von 697 Schwachstellen, die dieses Jahr in iPhone-Updates behoben wurden. So wie ich es sehe, wird schwierige Arbeit, für die man früher seltene Spezialisten brauchte, jedoch zunehmend mit Tools erledigt, und die Spezialisten behalten die Kontrolle.
Wer eine App veröffentlicht, kann ganz einfach vorgehen. Lassen Sie vor jedem Release eine KI nach Lücken suchen, übertragen Sie einer Person die Verantwortung für das, was die KI findet, und behandeln Sie die Funde wie jeden anderen Bug-Report. Und installieren Sie Ihre eigenen Updates, sobald sie erscheinen.
Worauf es hinausläuft
Nichts davon macht die großen KI-Anbieter überflüssig, und auch Angreifer können KI einsetzen. Doch ich glaube, beide Entwicklungen geben allen, die Software bauen, mehr Kontrolle: darüber, wohin ihre Daten gehen, und darüber, die Lücken in ihrer eigenen Software als Erste zu finden.
Wie es weitergeht
Wenn Ihnen solche Notizen helfen, ist der Newsletter der beste Weg, die nächste nicht zu verpassen.